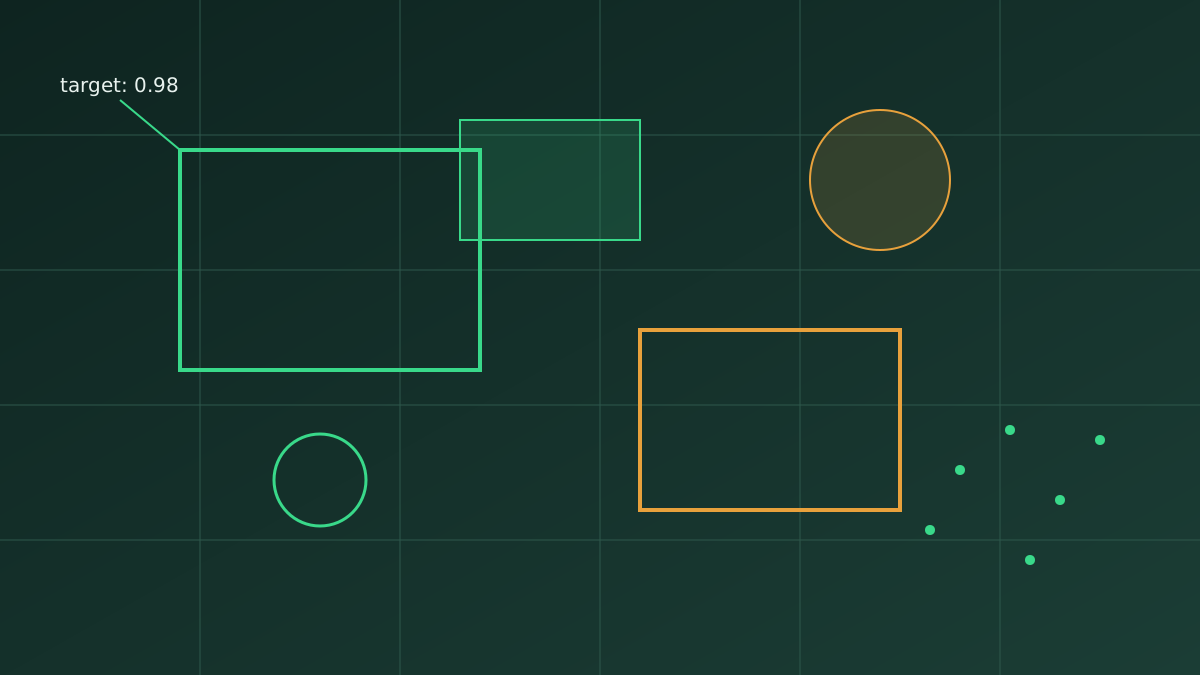
2D 矩形框标注
目标检测训练的基础任务,对图像中的车辆、行人、工件等目标拉取贴合矩形框并标记类别。
- 支持 COCO / VOC / YOLO 格式回传
- 单图目标数不限,含遮挡截断处理
- 通常按张计价,批次交付
很多返工不是标注员手误,而是需求在传递中走样:客户口头描述的“遮挡目标”,落到标注员那里就是五种理解。我们的做法是把需求先翻译成一份书面的标注规范——类别定义、边界情形(截断、遮挡、反光、密集重叠)、属性枚举值逐条写清,再取 50–200 张样本试标,双方确认合格后才进入量产。规范文档随数据一起交付,客户侧复训新标注员时也能直接使用。
不同模态对工具的要求差别很大:2D 拉框看的是效率,点云 3D 框要求多视图联动投影,语音标注要处理说话人分离与转写校对,大模型 SFT 数据则涉及偏好排序与回复质量分层。我们为每类任务配置对应的标注平台与插件,支持客户自有平台的 API 对接,也接受按客户格式回传——COCO、VOC、YOLO、JSONL 等常见格式都可以直接输出,省去客户侧的格式转换脚本。
质检不是最后看一眼,而是贯穿批次全程:组内互检做全量核对,质检组按比例抽检并记录每一条不合格原因。抽检不合格的批次整批返工,返工原因归类统计——是规范歧义、是个人误差还是工具缺陷,对应不同的修正方式。每个批次交付时附质检记录,客户发现可疑样本可以按 ID 快速回查到标注员与质检环节。
以下是我们日常承接的九类任务,绝大多数需求都能对应到其中一类;具体规格与交付方式可在产品服务页查看详细说明。
目标检测训练的基础任务,对图像中的车辆、行人、工件等目标拉取贴合矩形框并标记类别。
沿目标轮廓逐点勾勒,适用于需要像素级边界的场景,如医学影像区域、遥感地物、工业缺陷。
激光雷达点云中为车辆、行人等目标拟合带朝向的三维立方体框,服务于自动驾驶感知训练。
对录音做有效语音段切分、逐字转写与说话人标记,产出可用于语音识别与声纹训练的数据。
在文本中圈选人名、机构、产品、时间等实体并打上类型标签,常用于信息抽取与知识图谱构建。
围绕指令微调需求撰写问答对、按质量分层筛选,产出符合场景语气的对话训练数据。
对模型多条回复按有用性、安全性、事实性做排序或打分,为奖励模型训练提供偏好信号。
在连续视频帧中保持同一目标 ID 一致,处理遮挡、出画、再入画等典型情形,服务行为识别训练。
将整幅图像按类别逐像素划分,道路、建筑、植被等区域各有归属,是环境感知模型的高精度数据来源。
拿到样本数据后,我们先把口头需求整理成书面标注规范:类别清单、边界情形、属性枚举值逐条落定,双方确认后作为验收依据。
取 50–200 张样本试标,客户抽验合格率;对不理解的条目回到规范修订,直到双方对“合格”的理解一致。
按批次排产,组内互检全量核对,质检组抽检并记录不合格原因;进度按日回传,中途需求变更走规范变更流程。
按约定格式回传数据,附标注规范、质检记录与批次清单;客户验收发现问题按 ID 回溯定位,返工不另计费。
更多问答见常见问题详解,选型思路可阅读数据标注选型与采购指南。